Qu'est-ce que le robots.txt, et que peut-il vraiment faire ?
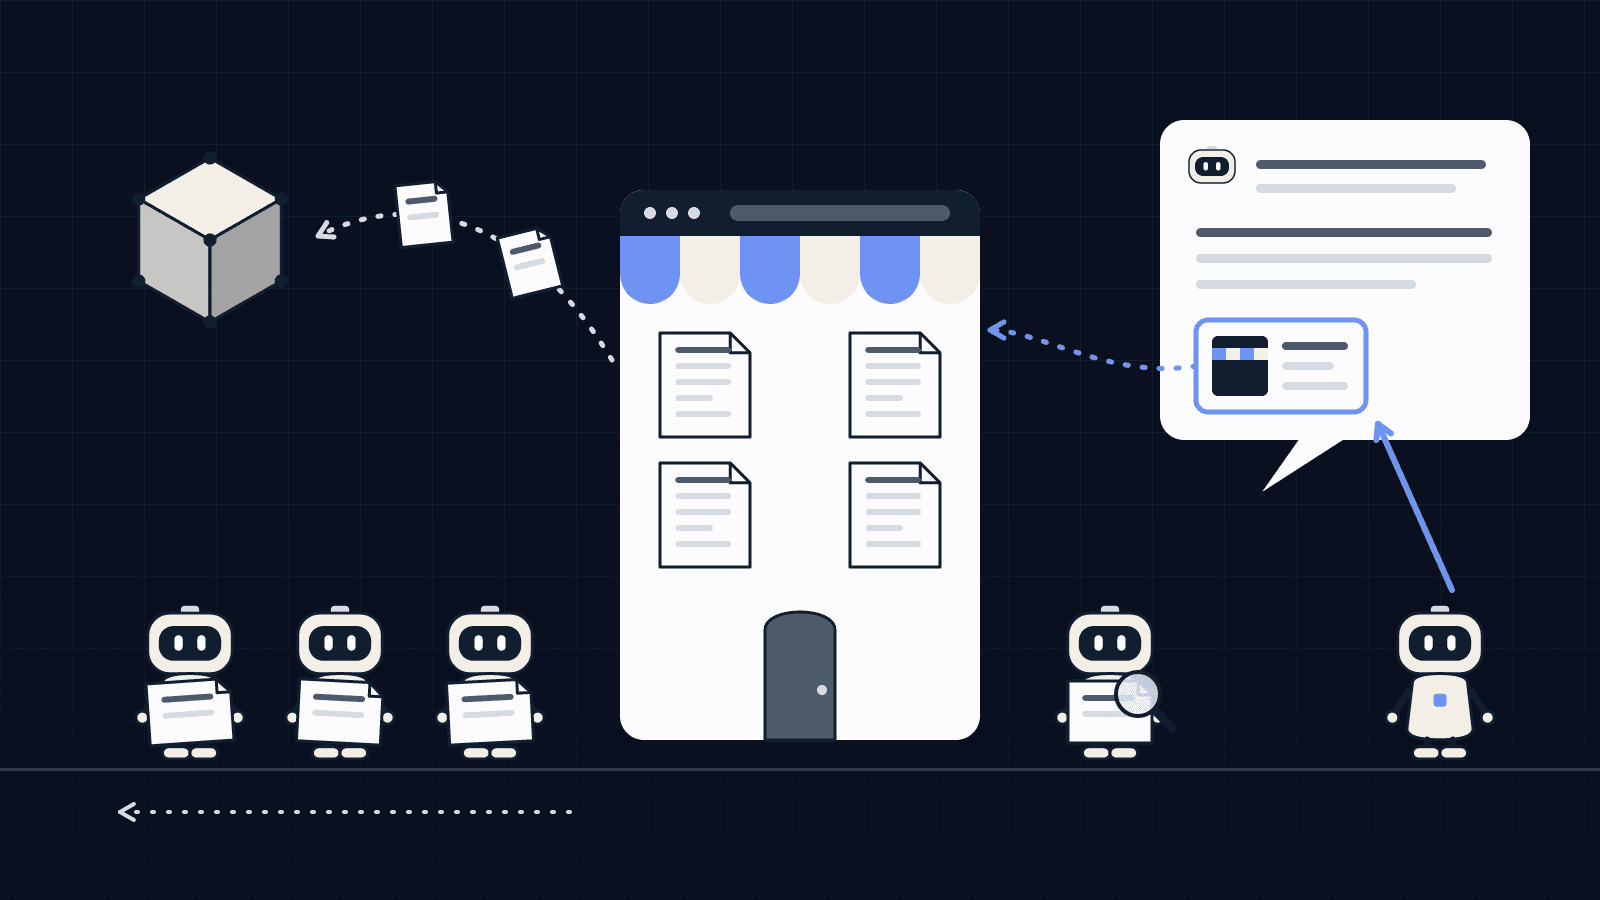
Le robots.txt est un fichier texte placé à la racine du site (votresite.fr/robots.txt). Il dit, robot par robot, quelles parties du site celui-ci peut parcourir. Les robots de Google, d'OpenAI et d'Anthropic annoncent qu'ils le respectent.
Trois limites à connaître. Ce fichier n'est pas un verrou : une page interdite reste ouverte à quiconque connaît son adresse, et Google précise qu'il peut afficher l'adresse d'une page bloquée dans ses résultats, sans extrait. Il ne vaut que pour l'hôte où il se trouve : www.votresite.fr et boutique.votresite.fr ont chacun le leur. Enfin, un robot qui ouvre une page à la demande d'un utilisateur peut ne pas le lire : OpenAI l'écrit pour ChatGPT-User.
Quels robots d'IA viennent sur votre site, et que se passe-t-il si vous les bloquez ?
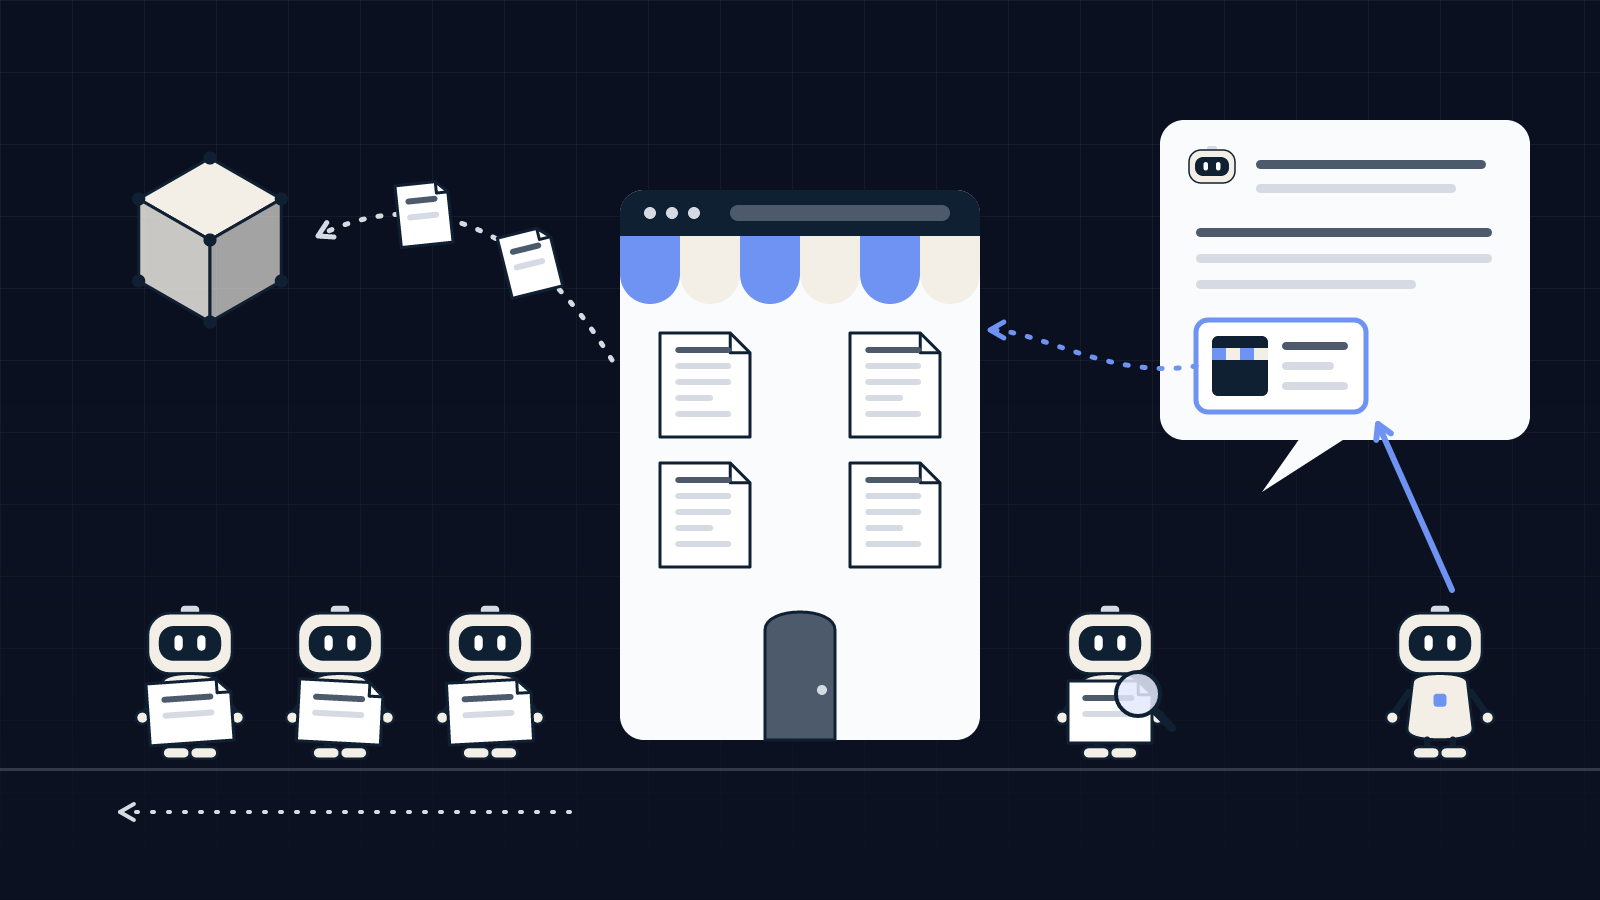
Chaque éditeur sépare désormais ses robots selon l'usage. Le tableau reprend ce que disent leurs documentations, lues le 30 octobre 2026.
| Éditeur | Nom dans le robots.txt | Ce qu'il fait | Si vous le bloquez |
|---|---|---|---|
| OpenAI | GPTBot | Collecte des pages qui peuvent servir à entraîner les modèles | Vous signalez que vos contenus ne doivent pas servir à l'entraînement. Aucun effet sur la recherche de ChatGPT. |
| OpenAI | OAI-SearchBot | Fait apparaître les sites dans les réponses de recherche de ChatGPT | Votre site n'est plus montré dans ces réponses, sauf comme simple lien de navigation. |
| OpenAI | ChatGPT-User | Ouvre une page quand un utilisateur le demande | Le robots.txt peut ne pas s'appliquer, selon OpenAI. |
| Anthropic | ClaudeBot | Collecte des pages qui peuvent servir à l'entraînement | Vos futurs contenus sont exclus des données d'entraînement. |
| Anthropic | Claude-SearchBot | Parcourt le web pour la recherche de Claude | Visibilité réduite dans les résultats de recherche de Claude. |
| Anthropic | Claude-User | Ouvre une page quand un utilisateur pose une question | Claude ne lit plus vos pages pour répondre à ses utilisateurs. |
| Googlebot | Parcourt le web pour la recherche Google | Vous sortez de Google. À ne jamais bloquer par erreur. | |
| Google-Extended | Jeton de contrôle, sans robot propre : entraînement des modèles Gemini et ancrage des réponses des applications Gemini | Aucun effet sur la présence dans la recherche Google ni sur le classement. Vos pages ne servent plus à l'entraînement ni à l'ancrage dans Gemini. |
La conséquence pratique : bloquer un robot d'entraînement ne vous retire pas des réponses de recherche des assistants. OpenAI l'écrit en toutes lettres : les deux réglages sont indépendants, et un site peut autoriser OAI-SearchBot tout en refusant GPTBot. Le cas de Google-Extended est à part, puisqu'un même nom couvre l'entraînement et l'usage de vos pages dans les réponses de Gemini.
Quel fichier écrire pour une PME qui veut être citée ?
Notre lecture, pour la plupart des PME : laissez lire tous les robots de recherche, y compris ceux des assistants, et décidez à part pour l'entraînement. Un site qui vend un service a peu à perdre à être cité, et la question de l'entraînement relève d'un choix de principe sur vos contenus. Voici un fichier qui refuse l'entraînement chez OpenAI et Anthropic et laisse tout le reste ouvert :
User-agent: *
Allow: /
Disallow: /espace-client/
# Entraînement des modèles : refusé
User-agent: GPTBot
User-agent: ClaudeBot
Disallow: /
Sitemap: https://www.votresite.fr/sitemap.xml
Si l'entraînement ne vous gêne pas, gardez seulement le premier bloc : un fichier ouvert à tous laisse passer les robots d'IA sans qu'il faille les nommer. Pour Google-Extended, ajoutez-le au groupe qui refuse seulement si vous acceptez de ne plus servir de source aux réponses de Gemini.
Un piège revient souvent quand on ajoute un groupe pour un robot précis. Google l'écrit dans sa documentation : un robot suit le seul groupe qui le nomme, et les règles générales (User-agent: *) ne s'y ajoutent pas. Si vous créez un groupe « User-agent: OAI-SearchBot » avec « Allow: / », ce robot ne lit plus la ligne qui protège /espace-client/. Recopiez dans chaque groupe les chemins qui doivent rester fermés.
Que change le signal commun annoncé le 30 octobre 2026 ?
Le signal prend la forme d'un nom de robot fictif, __usage_ai-training, décrit dans un projet de norme publié le même jour à l'IETF par un ingénieur d'Anthropic. On l'écrit comme un groupe ordinaire :
User-agent: __usage_ai-training
Disallow: /
Ce groupe exprime une préférence contre l'entraînement, pour tout le site ou pour certains chemins. Il ne bloque aucun robot : il dit ce que vous acceptez qu'on fasse de vos pages, pas qui peut les lire. Le groupe général « User-agent: * » ne compte pas comme une réponse à cette question : sans ligne __usage_ai-training, aucune préférence n'est exprimée.
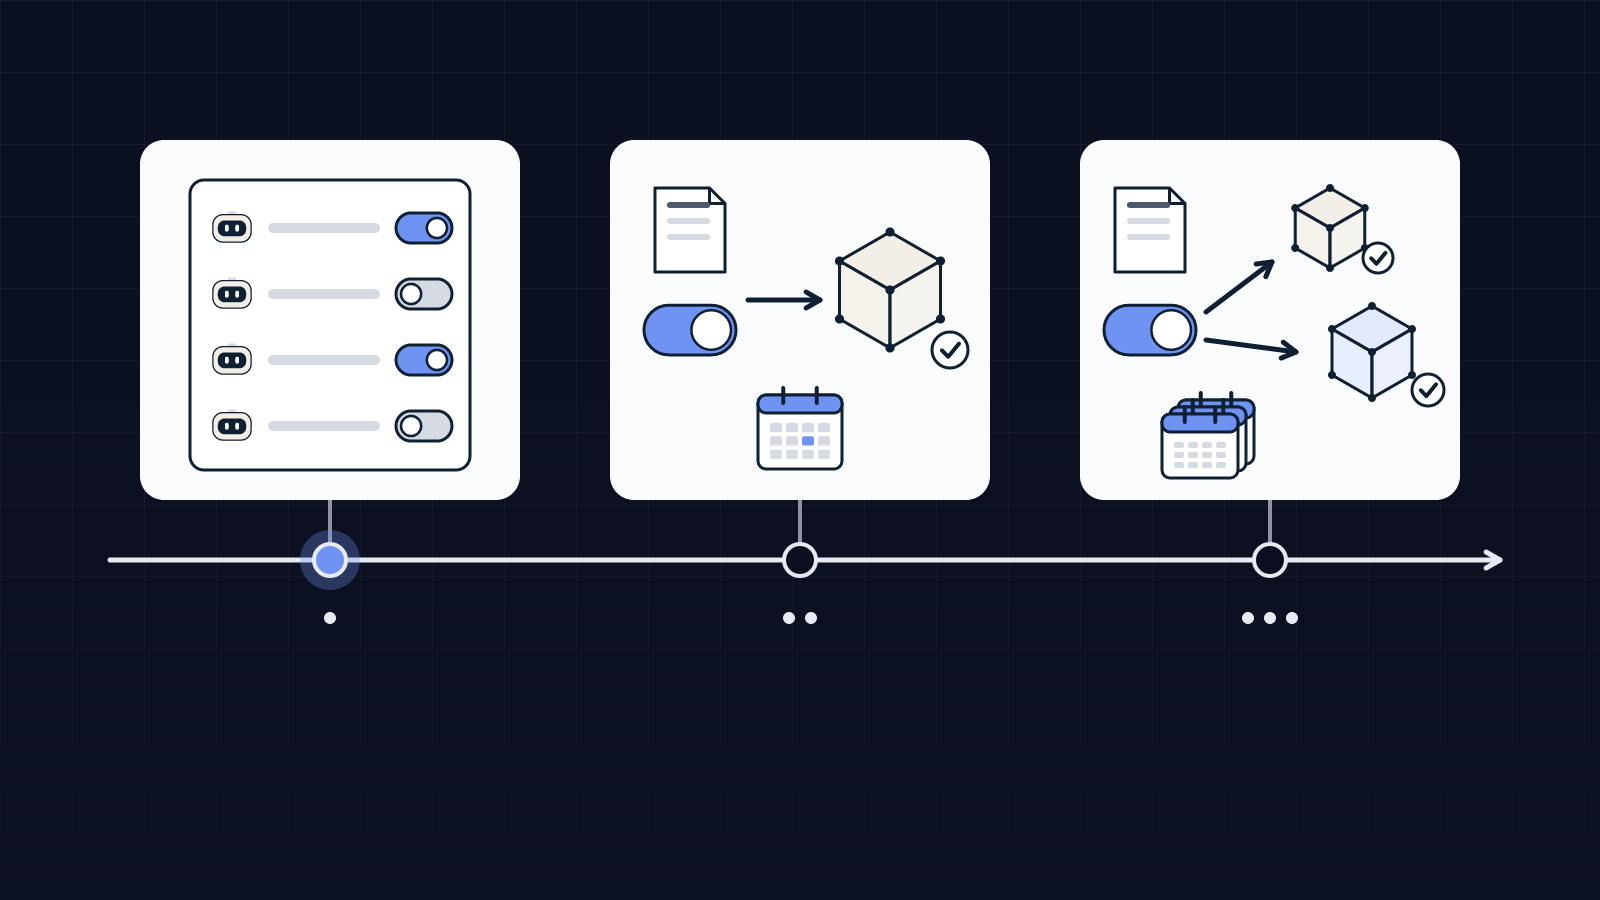
Le calendrier annoncé : Google vise une prise en compte en 2027, sans date. Quand le signal refuse l'entraînement et que le fichier ne nomme pas Google-Extended, Google prévoit de l'interpréter comme un refus adressé à Google-Extended. Microsoft commencera à appliquer ses nouvelles préférences (entraînement d'un côté, usage dans les réponses de l'autre) le 1er février 2027, selon le compte rendu de Search Engine Roundtable. Les réglages propres à chaque éditeur continuent de fonctionner.
Notre conseil : vous pouvez ajouter le groupe dès maintenant, puisque les robots qui ne le connaissent pas l'ignorent, mais gardez les lignes GPTBot et ClaudeBot. Le texte reste un projet, valable jusqu'au 3 mai 2027, et il peut changer d'ici là.
Ce que nous avons trouvé dans les fichiers de quatre agences IA
Le 30 octobre 2026, nous avons lu le robots.txt de quatre sites d'agences françaises qui vendent des agents IA aux entreprises : le nôtre et ceux de trois agences que nous suivons. Quatre fichiers, trois façons de faire.
- Deux fichiers ouverts à tous, sans nommer aucun robot d'IA, dont le nôtre. Le nôtre ferme seulement deux chemins (/api/ et la page de rapport du diagnostic) et déclare les sitemaps du site français et du site anglais.
- Un fichier qui nomme 16 robots un par un pour les autoriser (GPTBot, OAI-SearchBot, ClaudeBot, Google-Extended, PerplexityBot…). L'effet est le même qu'un fichier ouvert ; l'intention est simplement écrite noir sur blanc.
- Un fichier qui bloque 32 robots, dont GPTBot, ClaudeBot, Google-Extended et GoogleOther, avec une ligne supplémentaire qui accepte la recherche et refuse l'entraînement. Ses commentaires indiquent qu'il est écrit par l'outil de Cloudflare, le prestataire qui sert le site.
Le troisième cas est le plus instructif pour un dirigeant. Ce fichier laisse passer OAI-SearchBot et Claude-SearchBot, donc le site reste lisible pour la recherche de ChatGPT et de Claude. Mais il refuse Google-Extended, ce qui, d'après la documentation de Google, retire aussi le site des sources des réponses de Gemini. C'est peut-être un choix voulu. Ce que montre surtout ce fichier, c'est qu'un réglage du prestataire réseau peut écrire le robots.txt à la place de l'agence qui a fait le site : la personne qui pense en être responsable peut ne jamais l'avoir lu.
Comment vérifier et corriger le vôtre ?
- Ouvrez votresite.fr/robots.txt dans un navigateur, puis la même adresse pour chaque sous-domaine (boutique, blog, espace client).
- Cherchez une ligne « Disallow: / » sous « User-agent: * » ou sous « User-agent: Googlebot » : elle ferme tout le site à la recherche, et c'est l'erreur à corriger en premier.
- Repérez les noms des robots d'IA et comparez avec le tableau plus haut : ce qui est bloqué correspond-il à votre choix ?
- Demandez à votre prestataire qui écrit ce fichier : le logiciel du site, une extension, ou un service comme Cloudflare. Une modification faite au mauvais endroit sera écrasée.
- Après la modification, relisez le fichier en ligne. OpenAI indique qu'il faut compter environ 24 heures pour que la recherche de ChatGPT en tienne compte.
C'est la même démarche que pour la version de PHP à demander à votre hébergeur : savoir qui tient chaque réglage du site, et l'avoir par écrit.
Faut-il un agent IA pour surveiller ça ?
Non. Le fichier change rarement : une relecture par trimestre, et une autre à chaque changement de prestataire ou d'hébergement, suffisent. La vraie question pour une PME est plutôt dans l'autre sens : quels accès vous donnez aux outils d'IA qui travaillent pour vous. Elle est traitée dans les quatre questions à poser avant de brancher un agent IA sur vos outils, et c'est l'un des points que nous fixons par écrit pendant un cadrage.
Pour voir ce que nos agents prennent en charge dans une PME, et ce qui reste validé par une personne : agents IA pour PME.
FAQ
Bloquer GPTBot me fait-il disparaître de ChatGPT ?
Non. GPTBot sert à l'entraînement des modèles. La recherche de ChatGPT passe par OAI-SearchBot, et OpenAI précise que les deux réglages sont indépendants : vous pouvez refuser l'un et autoriser l'autre.
Bloquer Google-Extended nuit-il à mon référencement sur Google ?
Non, selon Google : ce jeton n'a aucun effet sur la présence d'un site dans la recherche Google et n'est pas un critère de classement. Il retire en revanche vos pages de l'entraînement des modèles Gemini et des sources utilisées dans les réponses des applications Gemini.
Le robots.txt efface-t-il ce qui a déjà été collecté ?
Les documentations lues parlent de la suite. Anthropic écrit que bloquer ClaudeBot exclut vos futurs contenus de l'entraînement ; OpenAI, que bloquer GPTBot indique que vos contenus ne doivent pas servir à l'entraînement. Aucune des deux ne parle de retirer ce qui a été collecté avant.
Dois-je ajouter le signal __usage_ai-training dès maintenant ?
Vous pouvez : il est sans effet chez les robots qui ne le connaissent pas. Google prévoit de le prendre en compte en 2027, et Microsoft annonce appliquer ses nouvelles préférences d'IA à partir du 1er février 2027. D'ici là, gardez vos lignes GPTBot et ClaudeBot, qui restent la façon reconnue de refuser l'entraînement.
Sources, toutes lues le 30 octobre 2026 : Google Search Central, « Supporting a shared AI training control for websites », John Mueller, 30 octobre 2026 (developers.google.com) · K. Kelley (Anthropic), « Machine-Readable Training Preference Signal », projet IETF draft-kelley-aipref-training-preference-signal-00, 30 octobre 2026 (datatracker.ietf.org) · OpenAI, « Overview of OpenAI Crawlers » (developers.openai.com) ; l'annonce d'OpenAI du 30 octobre n'était pas accessible, sa reprise par Unite.AI a été lue (unite.ai) · Anthropic, « Does Anthropic crawl data from the web, and how can site owners block the crawler? », 7 avril 2026 (support.claude.com) · Google, « Liste des robots d'exploration communs de Google », mise à jour du 20 octobre 2026, et « Comment Google interprète la spécification robots.txt » (developers.google.com) · Search Engine Roundtable, « Microsoft Bing New AI New Controls With AI Training From AI Search Grounding », Barry Schwartz, 30 octobre 2026 ; le billet de Microsoft n'a pas été lu. Le relevé des quatre fichiers robots.txt a été fait par Équipage IA le 30 octobre 2026. Aucun cas client n'est cité.